
Statistiche e metriche
Il nodo conta il traffico pubblico e lo mostra nella Panoramica del pannello; gli stessi contatori sono disponibili in formato Prometheus.
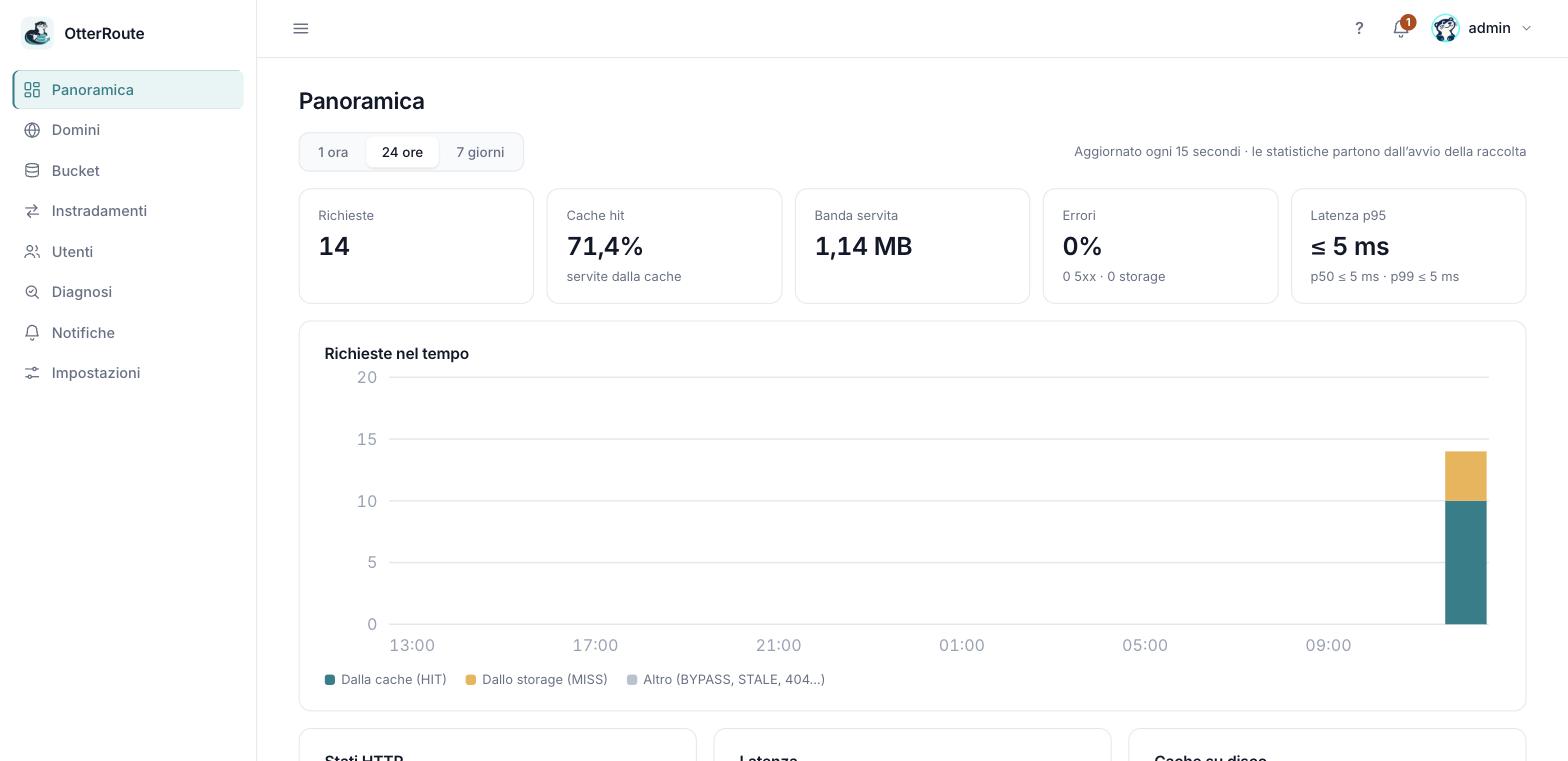
La Panoramica: richieste, cache hit, banda, errori e latenza · 26/09/2026
Cosa si misura
Per ogni richiesta pubblica:
- Richieste, per esito della cache (
HIT,MISS,STALE,REVALIDATED,BYPASS) e per classe di stato (2xx, 3xx, 4xx, 5xx). - Byte inviati, contati sul corpo davvero spedito (non sul
Content-Length). - Latenza fino alla risposta, in un istogramma con fasce da 5 ms a oltre 2,5 s, da cui si ricavano p50, p95 e p99.
- Errori dello storage, per bucket.
- L'attribuzione a instradamento e a file; le richieste senza regola vanno sotto "non instradato".
Non contano come traffico i controlli dei domini fatti dal pannello né le richieste alla porta del pannello.
La dashboard
Nella Panoramica scegli il periodo (1 ora, 24 ore, 7 giorni); la pagina si aggiorna ogni 15 secondi.
| Elemento | Cosa mostra |
|---|---|
| Richieste | Totale nel periodo. |
| Cache hit | Quota servita dalla cache: HIT + STALE + REVALIDATED contro MISS + BYPASS. I 404 e gli errori non hanno un esito di cache e restano fuori dal calcolo. |
| Banda servita | Byte inviati. |
| Errori | Percentuale di risposte 5xx, con il dettaglio degli errori dello storage. |
| Latenza p95 | Il 95% delle richieste è più veloce di questo valore (con p50 e p99). Il valore è il limite superiore della fascia dell'istogramma. |
| Grafico | Richieste nel tempo: dalla cache, dallo storage, altro. |
| Stati HTTP, latenza, cache su disco | Distribuzione per classe, istogramma, uso dello spazio. |
| Per instradamento / File più richiesti | Tabelle ordinabili. |
Chi non ha lo scope metrics:read non vede questa parte.
Come si conservano
Le statistiche stanno in memoria e vengono salvate su disco ogni minuto in metrics.json nella cartella di stato: sopravvivono ai riavvii. Le serie a 1 ora hanno risoluzione di un minuto, quelle a 24 ore e 7 giorni di un'ora. La classifica dei file va dall'inizio della raccolta e non è filtrata per periodo. Le statistiche partono da quando il nodo le raccoglie: non c'è storico retroattivo.
Prometheus
Sulla porta del pannello, GET /metrics espone i contatori in formato testo, senza login (come /healthz): per questo la porta 9090 deve restare accessibile solo in locale.
# prometheus.yml
scrape_configs:
  - job_name: otterroute
    static_configs:
      - targets: ["127.0.0.1:9090"]
Le metriche sono elencate in Metriche Prometheus. Alcune query utili:
# richieste al secondo, per instradamento
sum by (route) (rate(otterroute_requests_total[5m]))

# quota servita dalla cache
sum(rate(otterroute_requests_total{cache=~"HIT|STALE|REVALIDATED"}[5m]))
/
sum(rate(otterroute_requests_total{cache=~"HIT|STALE|REVALIDATED|MISS|BYPASS"}[5m]))

# latenza p95
histogram_quantile(0.95, sum by (le) (rate(otterroute_request_duration_seconds_bucket[5m])))

# errori dello storage
sum by (route, storage) (rate(otterroute_upstream_errors_total[5m]))

# cache piena oltre il 90%
otterroute_cache_bytes / otterroute_cache_max_bytes > 0.9
Limiti
- La latenza è il tempo fino alla risposta, non fino all'ultimo byte di un download lungo.
- L'esporter è nel nodo: se il nodo è spento non c'è nulla da leggere. Monitora anche
/healthzdall'esterno.